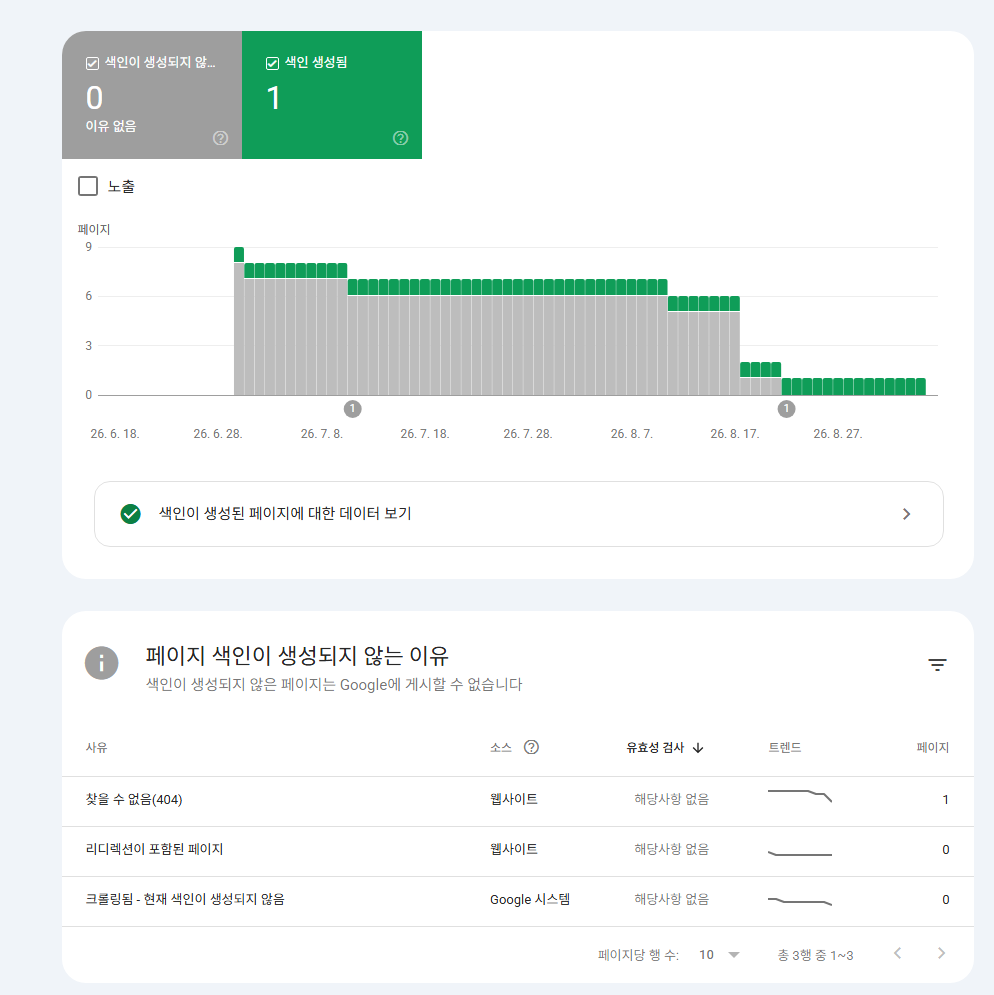
AI로 블로그 글 110편을 자동 발행했더니 구글 색인은 1개였다
이 블로그는 원래 AI가 자동으로 글을 쓰고 자동으로 발행하는 사이트였습니다. 8개월 동안 110편을 올렸고, 구글에 색인된 페이지는 1개였습니다. 오늘 글은 그 실패를 데이터로 뜯어본 기록입니다.
결론부터
- 발행한 글 110편 중 구글 색인 1개. 검색 유입은 사실상 0이었습니다.
- 기술적 문제는 하나도 없었습니다. robots 태그, canonical, 사이트맵 모두 정상이었습니다.
- 문제는 “사람이 읽을 이유가 없는 글을 기계 속도로 찍어낸 것” 하나였습니다.
- 모델을 더 좋은 것으로 바꾸는 건 해결책이 아니었습니다. 애초에 그게 병목이 아니었습니다.
무엇을 만들었나
구성 자체는 지금 봐도 멀쩡합니다.
- 수집 — 키워드와 소재를 크롤링으로 모으는 단계
- 생성 — LLM API로 제목, 본문, 이미지 프롬프트를 생성
- 발행 — 워드프레스 REST API로 대표 이미지까지 업로드해 자동 발행
- 스케줄러 — 클라우드 서버에서 하루 2~3회 정해진 시각에 실행
파이프라인은 정확히 설계대로 돌았습니다. 한 번도 멈추지 않았고, 원하는 시각에 글이 올라갔습니다. 기술적으로는 성공했고, 콘텐츠로는 완패했습니다.
데이터로 본 실패
비공개로 돌리기 전에 전체 글을 백업해서 직접 집계한 숫자입니다.
| 항목 | 수치 |
|---|---|
| 전체 글 | 110편 |
| 구글 색인 | 1개 |
| 본문 길이(중앙값) | 2,048자 |
| 글당 이미지 | 평균 1.3장 |
| 제목에 ‘3가지’가 들어간 글 | 32편 (29%) |
| 제목에 ‘비결’이 들어간 글 | 21편 (19%) |
| 큰따옴표로 시작하는 제목 | 36편 (33%) |
| 사이트 전체 태그 | 4,436개 |
발행 시각도 기록에 그대로 남아 있었습니다. 18:00에 17편, 09:00에 15편. 사람이 쓴 글이라면 나올 수 없는 규칙성입니다.
월별 분포는 더 나쁩니다. 1월 38편 → 2월 4편 → 3월 1편 → 7월 67편. 넉 달을 쉬었다가 한 달에 67편을 쏟아냈습니다. 새 사이트가 할 수 있는 최악의 패턴입니다.
기술 점검: 여기는 문제가 없었다
색인이 안 되면 대개 기술 설정부터 의심합니다. 저도 그랬고, 전부 확인했습니다.
- 글 페이지를 검색봇 이름으로 요청 → 200 정상 응답
- robots 메타태그 →
index, follow(막혀 있지 않음) - canonical 태그 → 자기 주소로 정상
- 사이트맵 → 108개 주소가 정상 등록, 검색 콘솔에도 제출 완료
- 이미지 미리보기 설정 →
max-image-preview:large적용
즉 구글은 글을 가져갈 수 있었고, 실제로 가져갔고, 색인하지 않기로 결정했습니다. “수집했으나 색인이 생성되지 않음” 상태입니다. 이건 기술 문제가 아니라 평가 결과입니다.
다만 robots.txt에는 실제로 오류가 하나 있었습니다. Sitemap: 줄의 형식이 깨져 있었고, 이미 쓰지 않는 옛 도메인 주소가 남아 있었습니다. 색인 실패의 원인은 아니지만, 이런 작은 방치가 쌓이면 사이트 관리 상태에 대한 인상이 됩니다.
그래서 진짜 원인 4가지
1. 제목이 템플릿이었다
110편 중 32편의 제목에 ‘3가지’가, 21편에 ‘비결’이 들어갑니다. 3분의 1은 큰따옴표로 시작합니다. 사람이 제목 목록을 훑어봐도 “같은 틀로 찍어냈다”는 게 한눈에 보입니다. 검색 엔진에게는 더 명확하게 보입니다.
2. 겪지 않은 일을 겪은 것처럼 썼다
「심박수 측정 직접 써본 리얼 후기」라는 제목의 글이 있었습니다. 저는 그 제품을 써본 적이 없습니다. AI가 그럴듯하게 만들어낸 문장이었습니다.
구글이 콘텐츠를 평가할 때 보는 기준 중 첫 글자가 경험(Experience)입니다. 직접 해본 사람만 쓸 수 있는 내용이 있는가. 제 글에는 그게 없었습니다. 없는 정도가 아니라, 있는 척했습니다.
3. 이미 지난 정보를 새 글로 올렸다
「2024년 생성형 AI 순위 TOP 5」라는 글의 발행일은 2026년 7월입니다. AI가 학습 데이터에 있던 옛 정보를 그대로 정리했고, 검수하는 사람이 없었습니다. 독자가 이 글을 클릭하면 2초 만에 뒤로가기를 누릅니다.
4. 사이트가 무슨 사이트인지 알 수 없었다
이미지 프롬프트가 절반, 나머지는 스마트워치, VR 기기, 여행, AI 뉴스였습니다. 소재가 떨어지면 아무 주제나 가져다 썼기 때문입니다. 검색 엔진 입장에서는 이 사이트를 어떤 분야의 참고 자료로 둘지 판단할 근거가 없습니다.
덤으로 태그가 4,436개까지 불어나 있었습니다. 글은 110편인데 말이죠. 대부분은 글 하나에만 붙었거나 아무 글에도 안 붙은 태그였고, 그만큼의 빈 페이지를 만들어내고 있었습니다.
내가 틀렸던 가정
결과가 안 나오는 동안 제가 만지작거린 것은 이런 것들이었습니다. 더 싼 모델로 바꾸기, 더 비싼 모델로 바꾸기, 제목 생성 프롬프트 고치기, 발행 횟수 늘리기.
전부 “글 쓰는 부분”만 건드린 조치였습니다. 하지만 검색 순위를 가르는 건 문장의 매끄러움이 아니라 그 글에만 있는 정보입니다. 직접 돌려본 결과, 실제로 찍은 화면, 직접 집계한 수치 같은 것들이요. 모델을 바꿔서 생기는 종류의 것이 아닙니다.
바꿔 말하면 이렇습니다. 자동화는 유통 문제를 풀어주지만, 콘텐츠 문제는 풀어주지 않습니다. 저는 유통 자동화를 만들어 놓고 콘텐츠 문제가 풀린 줄 알았습니다.
지금 한 조치
- 기존 글 107편 전부 비공개 전환 (삭제가 아니라 원문 백업 후 비공개)
- 자동 발행 크론 중단
- 카테고리를 3개로 재편 — AI 자동화 구축기 / AI 비용·도구 / 생각노트
- 태그 전량 정리
- robots.txt 재작성, 사이트 이름과 소개·문의·개인정보 페이지 전면 교체
앞으로는 주 2~3편만 씁니다. 직접 만들고 돌려본 것, 직접 계산한 비용, 실제로 실패한 기록만 올립니다. AI는 여전히 씁니다. 다만 초안을 정리하는 데 쓰고, 경험을 지어내는 데는 쓰지 않습니다.
같은 실수를 피하려면
- 색인이 안 되면 먼저 기술 설정을 확인하되, 정상이라면 원인은 품질이라고 인정할 것
- 제목 목록을 쭉 뽑아보고 같은 패턴이 30% 넘으면 템플릿을 갈아엎을 것
- 안 써본 제품에 ‘후기’라는 단어를 쓰지 말 것
- 연도가 들어간 제목은 발행일과 맞는지 반드시 확인할 것
- 한 달에 60편보다 넉 달 동안 매주 2편이 낫다
- 태그는 글당 3~5개로 제한할 것
다음 글에서는 이 자동 발행 파이프라인의 구조를 코드 수준에서 공개하고, 어느 부분을 남기고 어느 부분을 버렸는지 정리하겠습니다.
이 글의 수치는 2026년 9월 16일, 사이트 데이터를 직접 집계한 결과입니다.
