AI가 대체한 단계와 대체 못한 단계 — 8개월 자동화 실패를 두 지능으로 다시 읽기
AI에게 작업을 넘기다 보면 어느 순간 이런 질문이 옵니다. 그래서 나는 어디에 남아 있어야 하는가. 이 글은 8개월짜리 자동화 실패 기록을 ‘유동 지능 / 결정 지능’이라는 심리학의 오래된 구분으로 다시 읽어본 결과입니다. 결론부터 말하면, 제 파이프라인이 무너진 지점과 두 지능의 경계선이 정확히 겹쳤습니다.
결론부터
- AI가 대체한 단계는 전부 유동 지능(새 입력을 빠르게 처리하는 능력) 영역이었습니다.
- 대체하지 못한 단계는 전부 결정 지능(누적된 경험으로 판단하는 능력) 영역이었습니다.
- 110편을 발행하고 색인이 1개였던 이유는 모델 성능이 아니라, 결정 지능이 필요한 세 단계까지 자동화에 넘긴 것이었습니다.
- 결정 지능은 경험에서 자동으로 생기지 않습니다. 기록 → 구조화 → 기계가 읽을 수 있는 형태를 거쳐야 자산이 됩니다. 이 글의 후반은 그 구조에 대한 이야기입니다.
두 지능의 구분
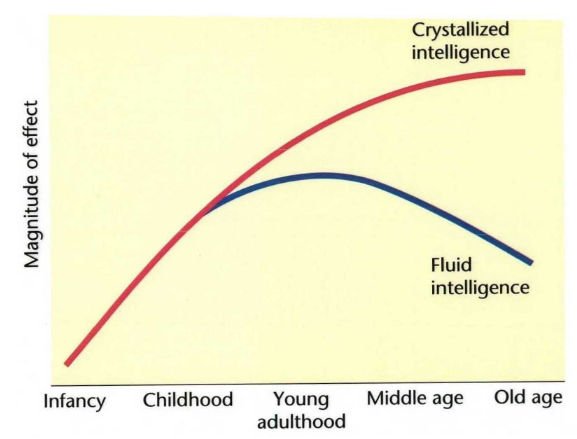
심리학에서는 지능을 두 축으로 나눠 봅니다. 새로 배운 개념이 아니라 오래된 구분인데, AI 시대에 다시 쓸모가 생겼습니다.
| 구분 | 유동 지능 | 결정 지능 |
|---|---|---|
| 정의 | 새로운 문제를 해결하고 정보를 빠르게 처리하는 능력 | 축적된 지식으로 패턴을 인식하고 타인에게 전달·조언하는 능력 |
| 연령 곡선 | 대략 39세 무렵 정점, 이후 완만한 감소 | 중년 이후 상승, 70~80대까지 유지 |
| 측정되는 장면 | 처음 보는 문제를 푸는 속도 | “이건 예전 그 케이스다”를 알아보는 정확도 |
여기서 중요한 건 LLM이 어느 쪽에 가까운가입니다. 대규모 언어모델은 방대한 지식을 갖고 있지만, 추론 시점에 하는 일은 “주어진 입력을 빠르게 처리해 그럴듯한 출력을 만드는 것”입니다. 축적된 자기 경험으로 판단하는 게 아니라 학습된 분포에서 다음 토큰을 고르는 것이죠. 겉으로는 결정 지능처럼 보이지만, 작동 방식은 유동 지능 쪽입니다.
그리고 유동 지능만 놓고 보면 인간은 이깁니다. 절대 못 이깁니다. 지치지도 않고 속도도 비교가 안 됩니다.
파이프라인 단계별로 갈라본 결과
제가 8개월 돌린 자동 발행 파이프라인의 단계를 그대로 놓고, 어느 쪽 지능이 필요한 일인지 표시해봤습니다.
| 단계 | 필요한 지능 | 자동화 결과 |
|---|---|---|
| 키워드·소재 수집 (크롤링) | 유동 | 성공. 사람보다 빠르고 정확 |
| 본문 생성 (LLM API) | 유동 | 성공. 2,000자를 수 초에 |
| 이미지 생성·삽입 | 유동 | 성공 |
| 스케줄 발행 (서버 크론) | 유동 | 성공. 8개월 무중단 |
| 이 소재를 쓸 가치가 있는가 | 결정 | 실패. 수요 없는 소재를 대량 생산 |
| 이 문장이 사실인가 | 결정 | 실패. 써본 적 없는 제품의 ‘사용 후기’ 발행 |
| 지금 내보내도 되는가 | 결정 | 실패. 2026년에 「2024년 TOP 5」 발행 |
표의 위 네 줄은 전부 통과했고, 아래 세 줄은 전부 무너졌습니다. 그 결과가 마지막 스냅샷 107편, 구글 색인 1개입니다. (8개월 총 발행량은 이보다 훨씬 많습니다. 반복해서 갈아엎고 지웠기 때문에 정확한 수를 저도 모릅니다.) . (집계 근거와 전체 데이터는 첫 글에 정리해뒀습니다.)
기술 점검에서는 아무 문제도 안 나왔습니다. 검색봇 응답 200, index/follow 정상, 사이트맵 정상. 당연합니다. 고장 난 건 유동 지능 쪽이 아니었으니까요.
내가 틀렸던 가정
실패하는 동안 제가 붙잡고 있던 가정은 “출력 품질이 올라가면 결과도 올라간다”였습니다. 그래서 프롬프트를 고치고 모델을 바꿨습니다.
지금 보면 이건 유동 지능 쪽 성능을 계속 올려서 결정 지능 쪽 공백을 메우려 한 것입니다. 문장이 아무리 좋아져도 “쓸 이유가 없는 글”이라는 판정은 뒤집히지 않습니다. 병목이 아닌 곳을 8개월 동안 최적화한 셈입니다.
덧붙이면, 이건 자동화를 쓰는 사람만의 함정이 아닙니다. 사람도 똑같이 합니다. 예전 방식대로 더 빨리, 더 많이 처리해서 상황을 돌파하려 할 때 번아웃이 오는 구조가 정확히 이것입니다. 속도를 올려서는 못 푸는 문제에 속도를 올리는 거죠.
결정 지능을 자산으로 바꾸는 3단계
경험이 많다고 결정 지능이 저절로 쌓이지는 않습니다. 저는 8개월을 겪고도 그게 데이터로 남아 있지 않았다면 이 글을 못 썼을 겁니다. 지금 쓰고 있는 구조는 3단계입니다.
1단계 — 결과가 아니라 판단을 기록한다
“자동화가 실패했다”는 기록이 아닙니다. 기록은 이런 형태여야 다시 쓸 수 있습니다.
- 무엇을 봤나 — 남은 107편, 색인 1개, 태그 4,436개, 제목의 29%가 동일 패턴0
- 무엇을 가정했나 — 품질을 올리면 색인이 따라온다
- 어디서 틀렸나 — 병목은 품질이 아니라 발행 여부 판단이었다
- 다음에 뭘 다르게 하나 — 발행 단계에만 사람을 남긴다
결과는 상황이 바뀌면 못 씁니다. 판단 기준은 다음 상황에도 씁니다. 결정 지능이 “패턴 인식 능력”이라면, 기록해야 할 건 사건이 아니라 사건에서 뽑아낸 패턴입니다.
2단계 — 흩어진 기록을 한 곳에 구조화한다
기록이 프로젝트 폴더마다 흩어져 있으면 찾지 못합니다. 찾지 못하는 기록은 없는 기록입니다.
저는 개인 위키 한 곳에 판단 기록을 모으고, 프로젝트별 운영 가이드 문서를 따로 둡니다. 이 블로그와 네이버 블로그도 각각 운영 가이드 한 파일에 원칙·금지사항·현재 상태가 다 들어 있어서, 새 작업을 시작할 때 그 파일 하나만 읽으면 됩니다. 과거의 내가 내린 판단을 현재의 내가 다시 안 내리게 하는 게 목적입니다.
3단계 — 기계가 읽을 수 있는 형태로 둔다
여기가 이번에 새로 얻은 부분입니다. 결정 지능이 내 머릿속에만 있으면 나 혼자 쓰지만, 구조화된 텍스트로 있으면 AI가 읽고 그 기준대로 일합니다.
저는 개인 위키를 MCP 서버로 연결해 AI 도구가 직접 조회하게 해뒀습니다. 그러면 관계가 이렇게 뒤집힙니다.
| 구조 | AI의 역할 | 결과 |
|---|---|---|
| 예전: AI가 판단까지 | 소재 선정·사실 확인·발행 결정 | 수천편 / 색인 1 |
| 지금: 내 판단 기록을 AI가 참조 | 수집·초안·정리만. 기준은 내 문서 | 주 2~3편, 발행 전 사람 검수 |
같은 도구인데 판단의 출처가 모델에서 내 기록으로 바뀐 것입니다. 모델은 계속 바뀌고 더 좋아지겠지만, 내 기록은 내 것으로 남습니다.
지금 적용 중인 체크리스트
- 자동화 대상을 단계별로 적고, 각 단계에 유동 / 결정 라벨을 붙인다.
- 결정 라벨이 붙은 단계는 자동화하지 않는다. 자동화했다면 되돌린다.
- 작업이 끝나면 결과가 아니라 판단 근거를 남긴다(본 것 / 가정 / 틀린 지점 / 다음 조치).
- 기록은 프로젝트마다 진입점 문서 한 개로 모은다. 새 세션이 그 파일만 읽고 이어갈 수 있어야 한다.
- 모델 교체로 해결하려는 충동이 들면, 먼저 병목이 어느 쪽 지능인지 확인한다.
정리
AI는 유동 지능이 사실상 무한하고 결정 지능이 0입니다. 사람은 반대 방향으로 갑니다. 나이가 들수록 유동 지능은 내려가고 결정 지능은 올라갑니다.
그러니까 AI와 겹치는 영역은 시간이 갈수록 줄어드는 게 맞습니다. 문제는 남은 영역을 쓸 수 있는 형태로 갖고 있느냐입니다. 판단은 기록되지 않으면 사라지고, 기록은 구조화되지 않으면 찾을 수 없고, 구조화된 기록만이 나와 AI 양쪽에서 쓰입니다.
제 8개월은 그걸 안 한 상태로 자동화부터 돌린 결과였습니다.
